把差评交给 AI 整理很有用,让 AI 凭空模拟 100 个消费者却可能把猜测写成结论。本文用 3 条红线、5 步 VOC 流程和一段可复制的提问模板,教你整理评论、客服与退货原因,再把结论落到商品页、广告和订单实测。
比如,把 500 条评论丢给 AI,让它找出顾客最常抱怨的事。这个动作能省掉很多逐条整理的时间。
再问它“请模拟 100 个美国消费者,投票选出他们最想买的广告卖点”,屏幕上很快会出现百分比、人群和购买理由。
两份结果都很整齐,身份完全不一样。
前一份在整理顾客实际说过的话。后一份由 AI 自己分饰了一百个顾客,再让这一百个人给它自己的想法投票。
结果读起来太像研究,人就很容易忘了,这些“消费者”从没进过你的店,也没买过你的东西。一份表格看着越像研究,团队越可能拿它去买广告和改产品。
The CPG Guys 在 2026 年 8 月 20 日发布了一期节目,嘉宾是 Insights Association CEO Anita Watkins。节目里有一个很扎眼的题目,叫“Simulating Humans”,也就是模拟人类。
Anita 把合成数据的位置讲得很清楚。它适合放在研究前端,用来探索问题、生成假设和模拟场景。真实用户数据和人的判断,一直要在回路里。
这个边界对大公司有用,对样本更少、决策更快的独立站更要紧。
AI 很会“圆”,这正是它在 VOC 里的风险
独立站卖家做 VOC,手里的材料通常很碎。亚马逊和独立站的评论分开放,客服对话在另一个系统,退货原因只有几个简短选项,TikTok 评论又是另一种口气。
AI 擅长把这些碎片收拢起来。它能找重复问题,给原话打标签,分出购买前的顾虑和使用后的不满,还能提醒你某个结论里有反例。
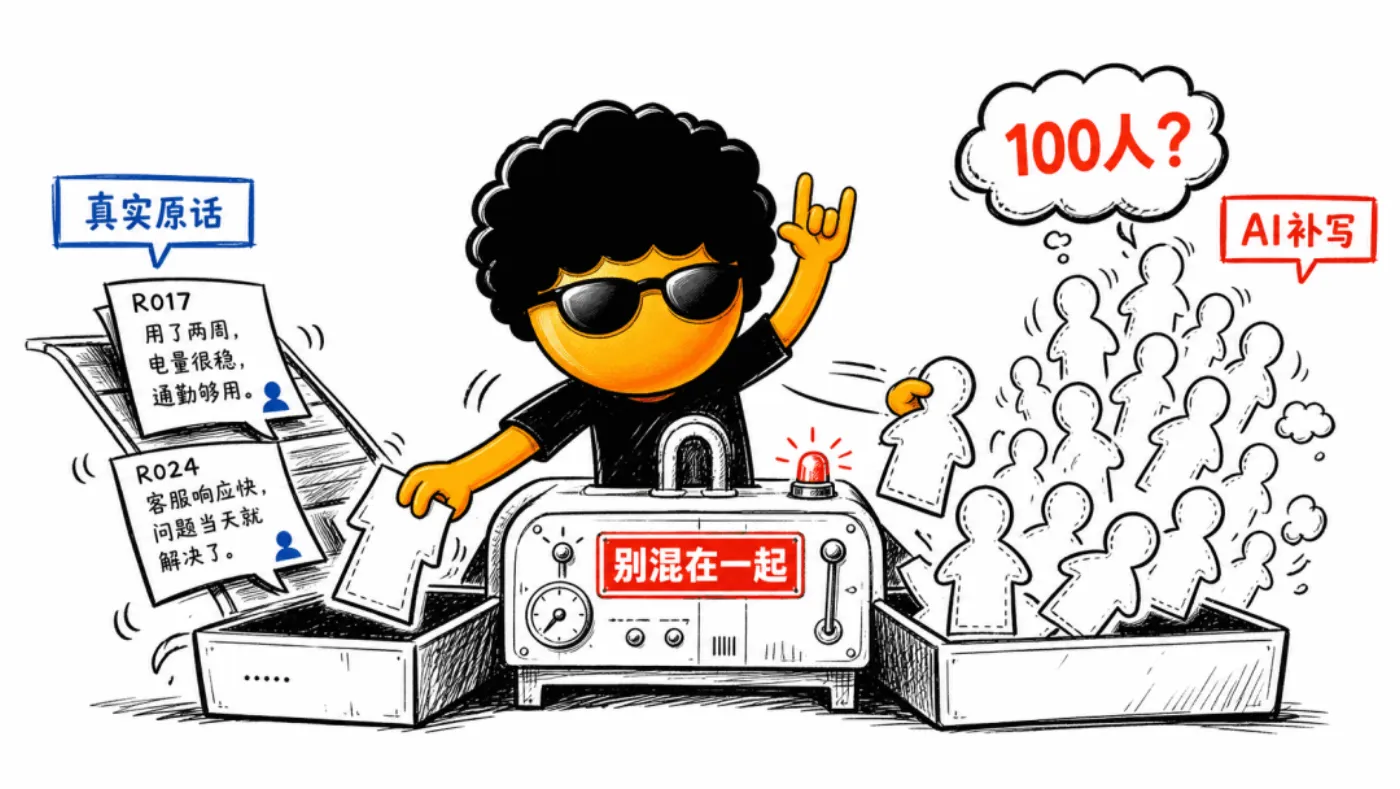
它也特别擅长把缺的部分补圆。
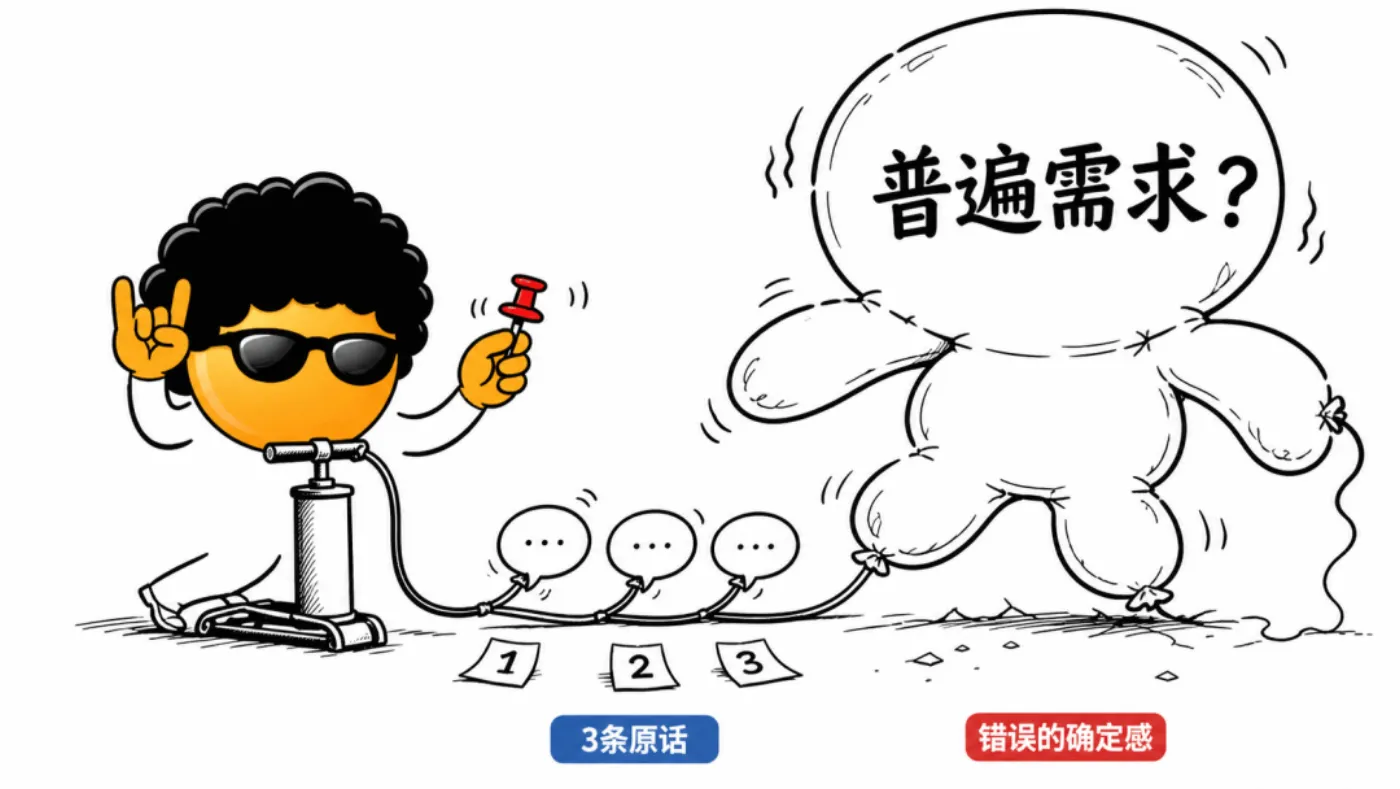
假设材料里只有 3 个人提到安装麻烦,AI 可以把它写成“北美家庭普遍关注安装便利性”。你让它再深入一点,它还能给出年龄、收入、家庭结构和购买概率。
话越来越完整,材料却没有变多。
Anita 在节目里提到一个很准的风险,错误的确定感。合成用户的数据来源、更新时间和代表性如果没讲清楚,整齐的结论只会让决策错得更果断。
第一条红线,没有原话就没有用户结论
把产品介绍、竞品页和市场报告喂给 AI,它可以帮你准备调研问题。这些材料还不能替顾客开口。
一个结论如果要写进商品页、广告脚本或产品路线图,它后面至少要跟着一条可以找回去的用户原话或用户行为。
“顾客担心尺寸”还不够。要能找回那条客服对话,看到他担心的到底是浴缸放不下,还是安装后门打不开。两者都叫尺寸问题,要改的页面内容却不一样。
有了原话,团队才能回到起点重看,也才能发现 AI 把两个问题混在了一起。
第二条红线,别让同一个 AI 既当受访者又当裁判
这是最容易省时间的做法。
先让 AI 模拟三类人群,再让这三类人群评价五条广告,最后请 AI 选出冠军。一套流程跑完,会议也省了,广告似乎马上就能上。
可这个冠军只证明了模型喜欢自己最会写的答案。
AI 可以参与评价,评价材料要来自真实世界。可以看点击、加购、订单、退货,也可以找顾客做短访谈。一条广告用了 AI 仿真人物也没关系,谁为它付钱,仍要回到真实访客。
第三条红线,百分比必须有分母
“63%的消费者更关心便携性”。
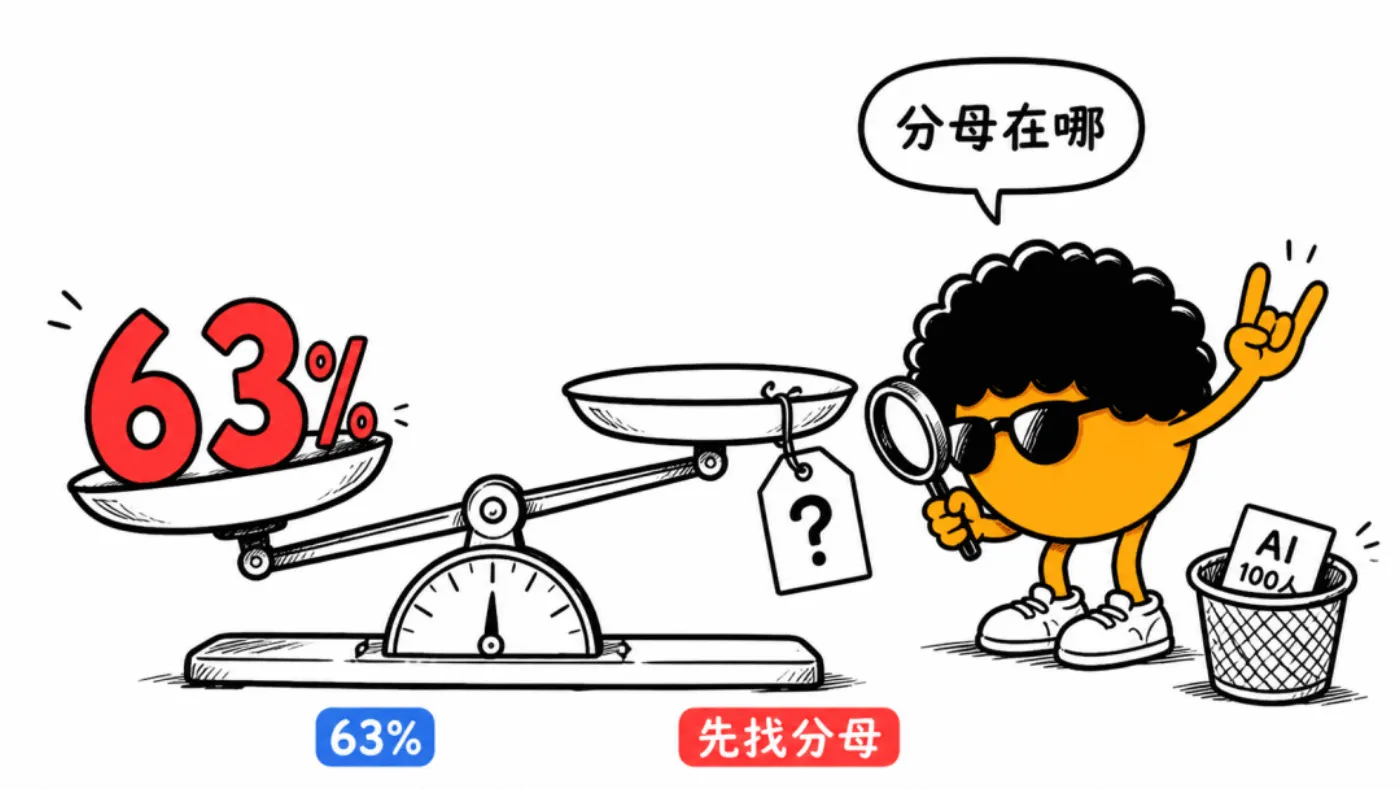
这句话看起来很好用,甚至可以直接放进 PPT。先问一句,63%是谁除以谁。
如果分母是 AI 模拟出来的 100 个角色,这个百分比只能代表这一次模型输出,不能代表消费者占比。
真实的 VOC 材料里也别急着计算漂亮的比例。三十条差评可以帮你找到问题,很难替整个市场分配精确百分比。对小卖家来说,先把“有这个问题”找出来,就已经能改页面、改客服回复或准备下一轮广告。
一套五步 VOC 工作流
这套流程不需要专门的市场研究团队。运营、客服和投放一起就能开始。
第一步 拿回最近的用户原话
从最近 90 天的评论、客服对话、退货说明和站内搜索词里取材料。单量少时,先收 30 条。材料多时,按市场、产品和购买前后分开抽。
删掉姓名、电话、邮箱、地址和订单号,给每条材料一个编号。
第二步 让 AI 只做整理
先别问“我的消费者是谁”。让 AI 标出每条原话里的使用场景、购买阻力、期待结果和情绪。
同一类问题里要保留相反意见。有人嫌包装大,也有人因为包装扎实才放心。这类分歧可能指向两个完全不同的购买场景,要单独留下。
第三步 做一张证据表
表格可以这样记,下面两行是格式示例。
| 用户原话编号 | 场景 | 阻力 | 当前证据 | 可改的地方 |
|---|---|---|---|---|
| R017 | 小户型安装 | 担心开门冲突 | 客服对话原话 | 商品页补安装尺寸图 |
| R024 | 收货后组装 | 步骤看不懂 | 差评与退货说明 | 首屏提前展示组装时间 |
这张表要保留原话编号。两周后团队对某个结论有分歧,不用靠记忆吵,点回原文就知道顾客当时怎么说的。
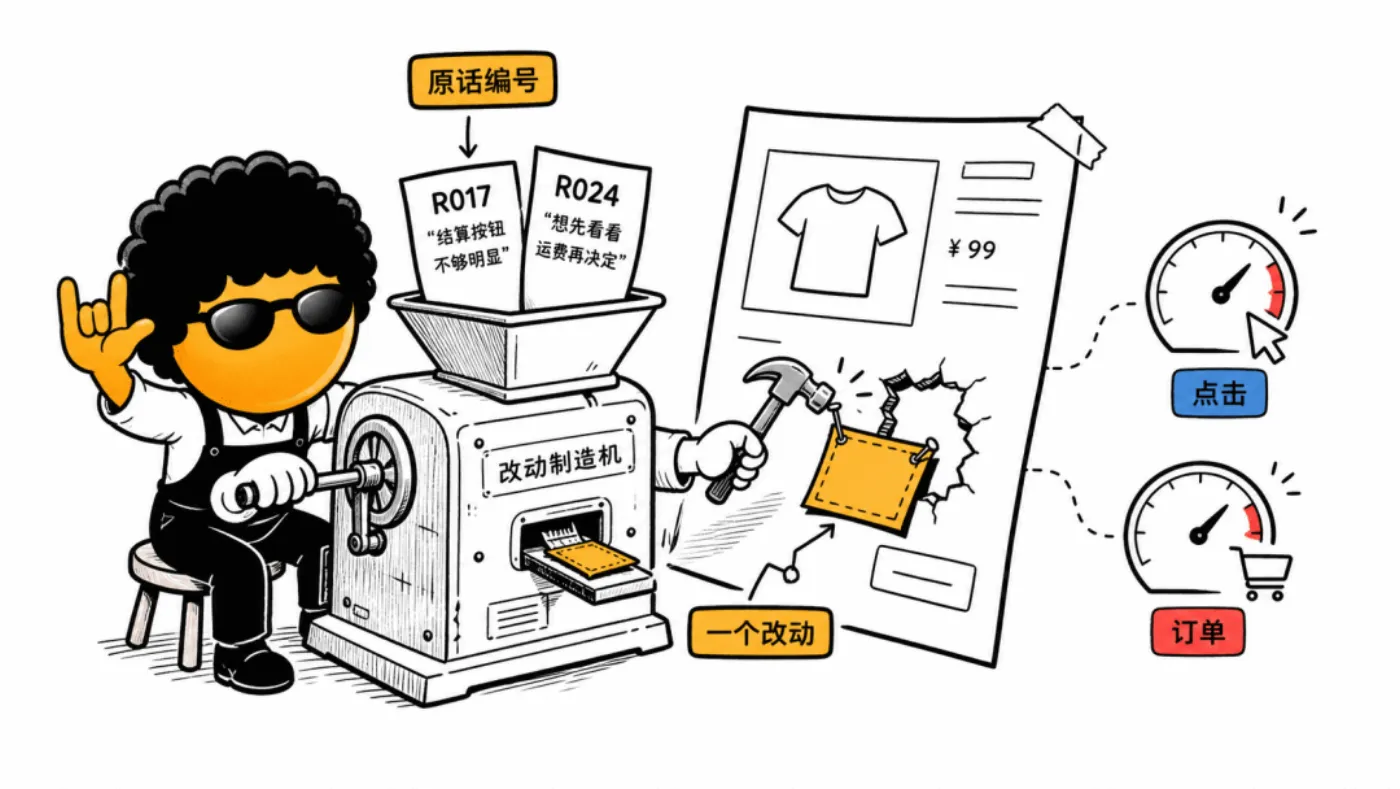
第四步 把结论变成一个可实测的改动
一个问题只改一个主要位置。尺寸焦虑很高,先改商品页的尺寸说明。顾客总在付款前问交期,先把时效放到购买按钮附近。
广告也一样。从原话里找一个高频阻力,写成一组新钩子,用真实点击、加购和订单让它继续往下走。
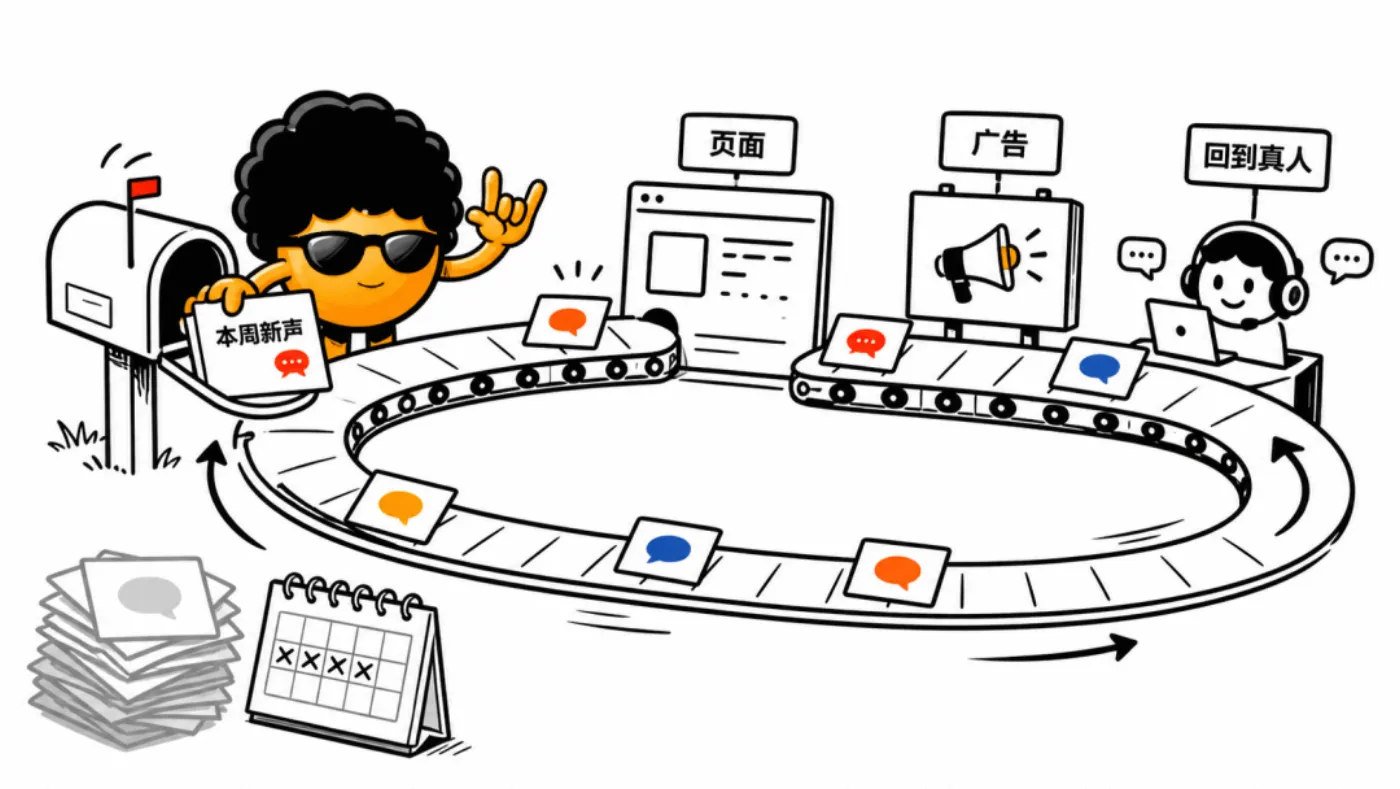
第五步 每周把新声音放回去
这一步很容易丢。一份 VOC 报告做完以后,团队忙着改页面,后面的评论和退货原因没再进来。三个月后,AI 仍然在反复概括上一轮的顾客。
每周加一批新材料,保留日期、市场和产品。人会变,价格、广告和配送时间也会改变他们的说法。节目里也特别提到,模型要频繁用新的人类数据刷新,否则会慢慢与消费者脱节。
这段提问可以直接复制
把整理好并完成脱敏的 VOC 材料放在提问后面。
你是一名 VOC 研究助理。只分析我提供的材料,不补写用户背景,不模拟额外用户,不自行生成百分比。把每条材料标出使用场景、购买阻力、期待结果和情绪。合并明显重复的问题,保留相反意见和少数反例。每个结论必须列出对应的原话编号。找不到原话时,请写“材料里没有这个结论”。最后输出一张表,包含用户原话编号、场景、阻力、当前证据、可改的页面或运营动作。

这段提问有点笨,它不会一次性给你一份三年品牌战略。它只会帮你把顾客说过的话收好,找到现在最值得改的地方。

对大多数独立站,这已经很值钱。

AI 可以替你读完一千条评论,它替不了那个付过钱、拆过快递,后来又退了货的顾客。

## 参考资料

-

The CPG Guys 第 615 期节目  http://cpgguys.com/anita

拓展阅读:

[Calla Shoes 如何把一个小众脚痛问题卖到92个国家](https://mp.weixin.qq.com/s?__biz=MzcwNDM3ODE1MQ==&mid=2247483912&idx=1&sn=5be70032e9a546dc0775f1ff0bc3be9f&scene=21#wechat_redirect)

[2人独立站卖出10000单,从处理第一条差评开始](https://mp.weixin.qq.com/s?__biz=MzcwNDM3ODE1MQ==&mid=2247483872&idx=1&sn=5a0bc161e0b534e43a46ac780c737aa1&scene=21#wechat_redirect)